Badanie podatności za 25 dolarów: co tanie AI oznacza dla VDP
Badacz znalazł WordPressowe RCE klasy 500 tys. dolarów za 25 dolarów mocy obliczeniowej AI. Sprawdź, jak tańsze badanie podatności może zmienić obciążenie triażu i budżet nagród.
Ernest Bursa
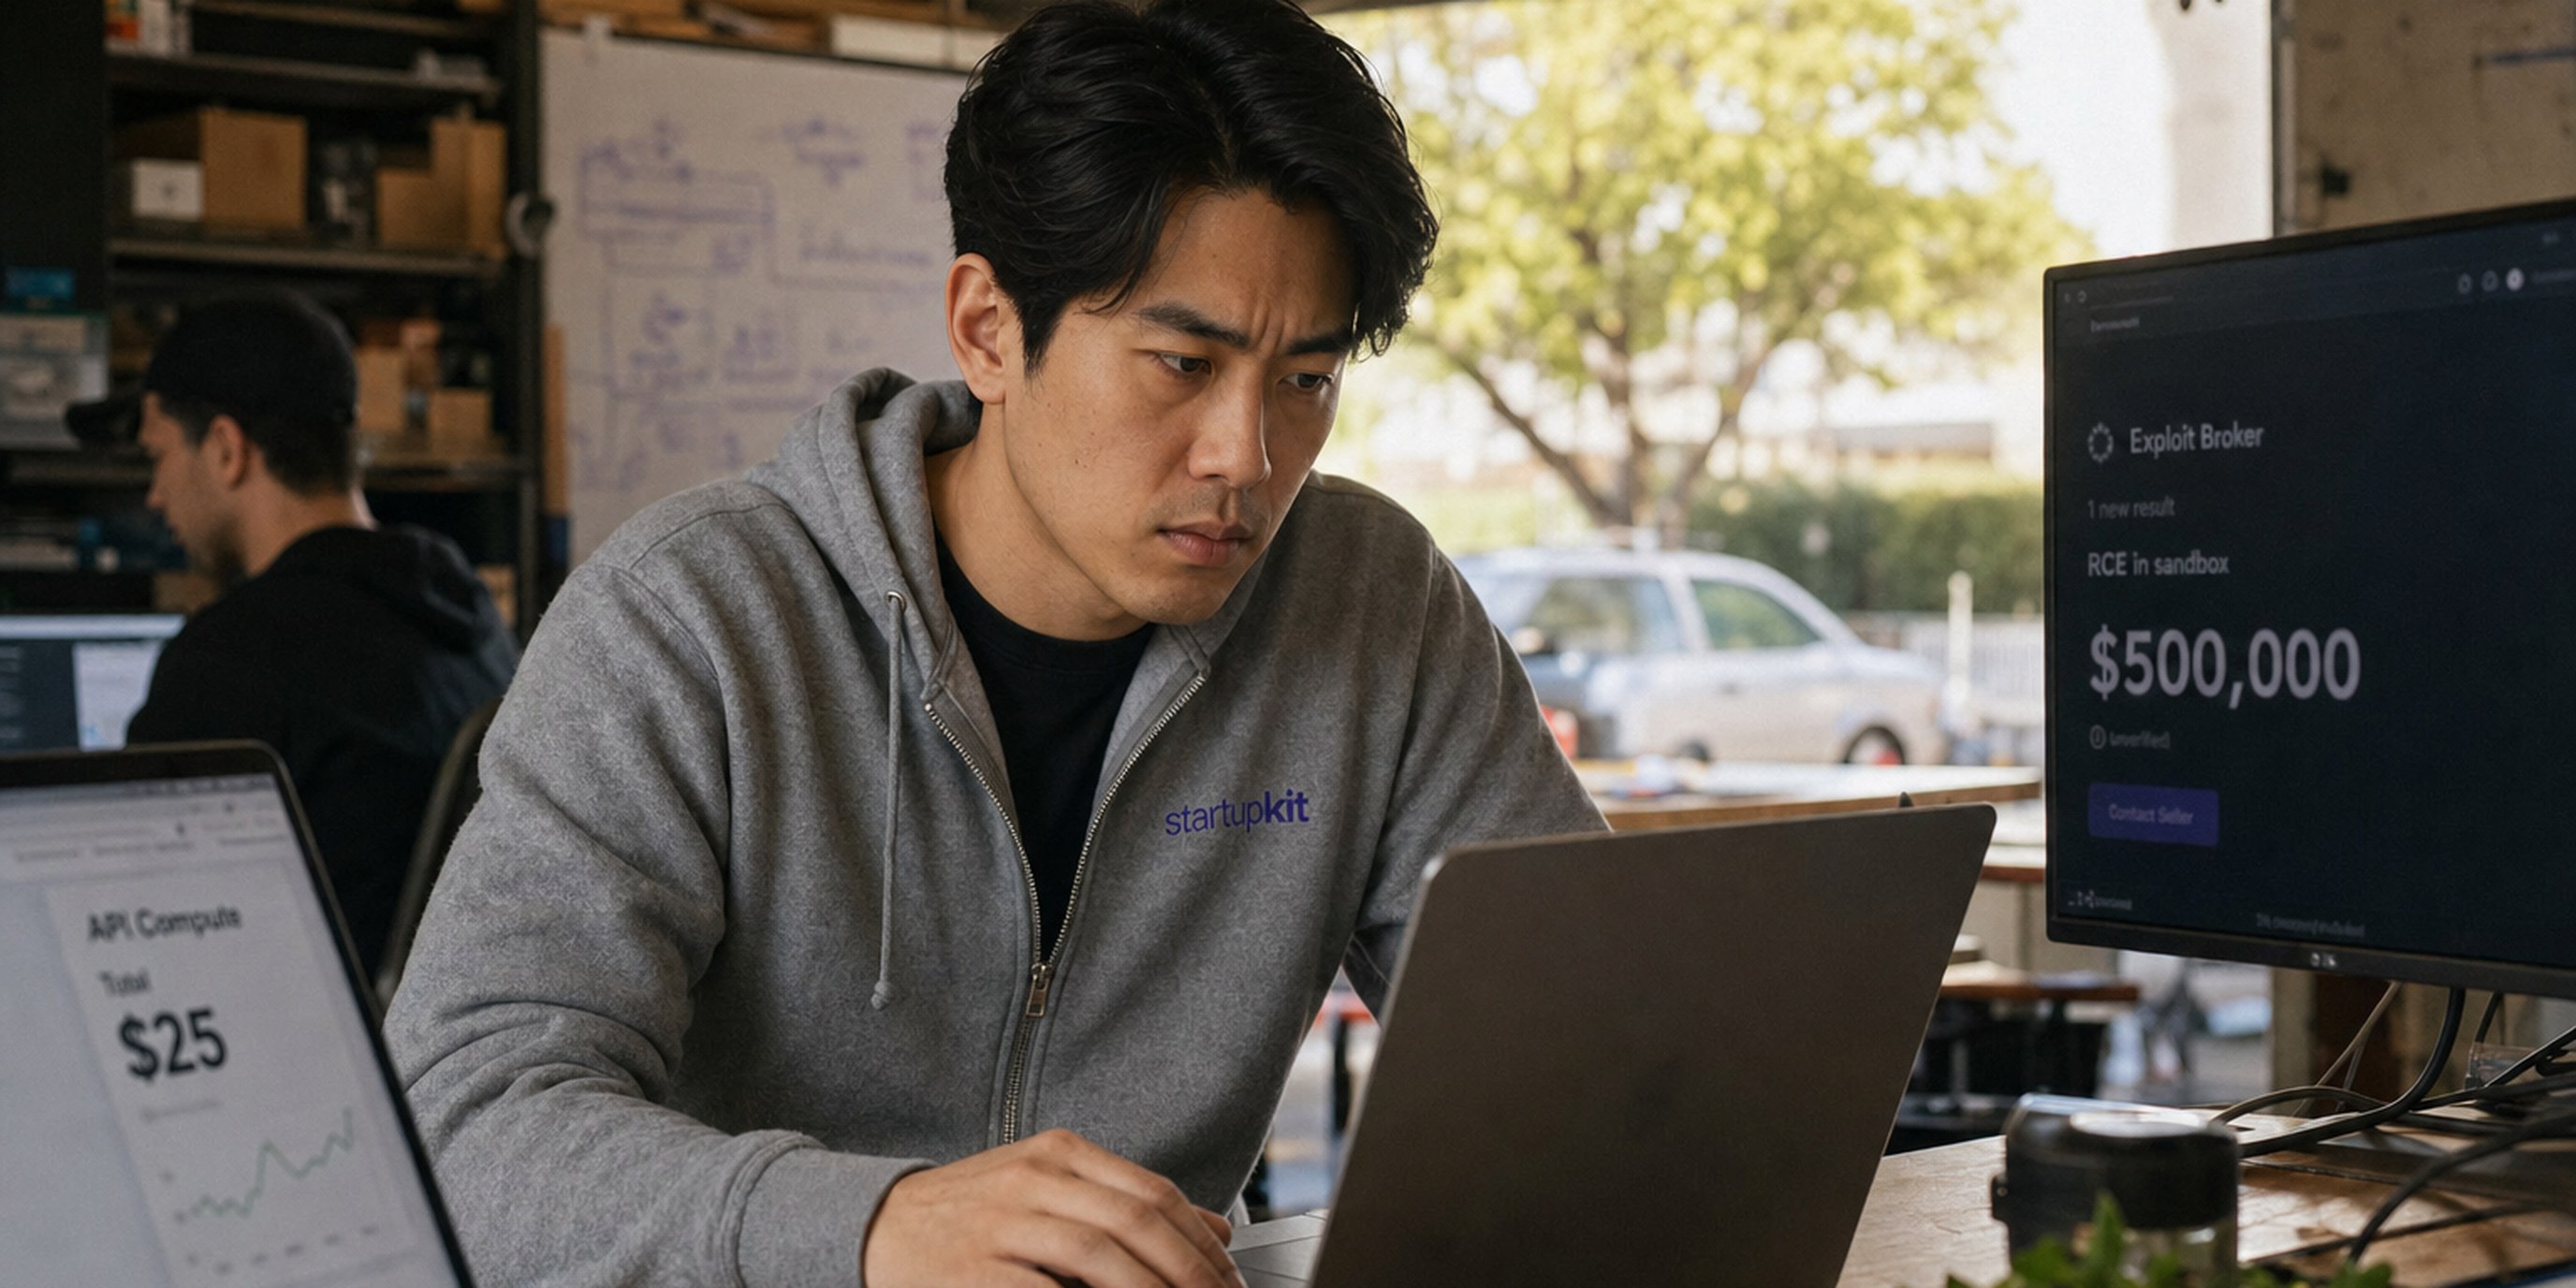
AI może znacznie obniżyć koszt znalezienia krytycznego błędu. Badacz z Searchlight Cyber skierował czołowy model na rdzeń WordPressa, wydał około 25 dolarów na moc obliczeniową w ciągu mniej więcej dziesięciu godzin i znalazł podatność SQL injection dostępną bez uwierzytelnienia, prowadzącą do zdalnego wykonania kodu. Brokerzy exploitów wyceniają taką klasę błędów nawet na 500 000 dolarów. To przykład innego obciążenia niż spam AI: prawidłowe, krytyczne zgłoszenia mogą napływać szybciej, niż zespół zdąży je potwierdzić, zweryfikować i wypłacić za nie nagrody.
Jeśli prowadzisz program ujawniania podatności (VDP) albo bug bounty, sprawdź, jak wzrost liczby prawidłowych zgłoszeń wpłynąłby na terminy, budżet nagród i obsadę triażu.
Co się właściwie wydarzyło i co jest potwierdzone
Adam Kues, badacz z Searchlight Cyber, zaadaptował przepis na promptowanie AI w wieloagentowy zestaw do polowania na podatności i skierował czołowy model na kod źródłowy WordPressa. Badacz podaje, że wykrycie podatności SQL injection typu pre-auth, eskalującej do RCE, zajęło ponad dziesięć godzin czasu pracy modelu i kosztowało około 25 dolarów. Następnie odtworzył ją na standardowej instalacji WordPressa, prosząc model o wykradzenie adresu e-mail administratora, a model wypisał ten adres w kilka minut. Wstrzymał publikację i przygotował zgłoszenie do ujawnienia.
Liczą się tu dwa punkty odniesienia i tylko jeden jest niezależnie potwierdzony. Kwota 25 dolarów i dziesięć godzin działania modelu to relacja samego badacza o własnej pracy, więc traktuj je jako deklarację, a nie potwierdzony fakt. Wycena 500 000 dolarów to ta, którą da się sprawdzić: publiczny cennik Exploit Acquisition Program firmy Crowdfense podaje „WordPress (RCE): 500k USD”, ten sam poziom co zdalne wykonanie kodu w Apache HTTP Server i Microsoft IIS, powyżej Nginxa wycenianego na 350 tys. i znacznie powyżej innych systemów zarządzania treścią, jak Joomla (40 tys.) czy Drupal (25 tys.). To publiczna cena maksymalna dla tej klasy błędów, a nie potwierdzona wycena konkretnego znaleziska. W źródle nie przypisano żadnego CVE, a dokładna nazwa modelu pochodzi z narracji artykułu, nie ze specyfikacji gotowego produktu.
Kwota z cennika brokera nie jest potwierdzoną ofertą zakupu tego konkretnego błędu.
Oprócz śmieci AI przybywa prawidłowych zgłoszeń
W dyskusji o AI i bug bounty często wracają zmyślone CVE, nieistniejące funkcje i szablonowe zgłoszenia. Opiekun curl Daniel Stenberg publicznie opisywał czas tracony na ich sprawdzanie. Ten problem omawiamy w artykule Śmieci AI zalewają triaż bug bounty. Filtry pomagają ograniczać szum, ale każde podejrzenie trzeba ocenić.
Relacja o znalezisku w WordPressie pokazuje inne ryzyko: niski koszt wyszukiwania może zwiększyć liczbę prawidłowych zgłoszeń o poważnych podatnościach. Taki wzrost obciąży zarówno triaż, jak i zespół naprawiający błędy oraz budżet nagród.
Oba rodzaje zgłoszeń mogą trafiać do tej samej kolejki. AI może pomóc znaleźć błąd, ale też stworzyć przekonującą fałszywkę, przedstawić stare CVE jako nowe lub powołać się na nieistniejącą funkcję. Oceniaj dowody w każdym zgłoszeniu.
Jak niższy koszt badania może wpłynąć na budżet programu
Nagroda w programie i cena brokera odpowiadają różnym warunkom zakupu oraz wykorzystania błędu. Niższy koszt badań może zwiększyć podaż zgłoszeń, ale nie oznacza, że każdy badacz znajdzie taki sam błąd za 25 dolarów ani sprzeda go za 500 000.
Zestawmy trzy liczby obok siebie:
| Kwota | Źródło | |
|---|---|---|
| Koszt odkrycia błędu | ~25 dolarów | Podany przez badacza wydatek na moc obliczeniową |
| Wartość na szarym rynku | do 500 000 dolarów | Cennik Crowdfense (potwierdzony) |
| Ile typowy VDP płaci za tę samą klasę | od 0 do niskich pięciocyfrowych kwot | Zależnie od programu |
Przy przykładowej nagrodzie 5 000 dolarów różnica wobec maksymalnej ceny brokera 500 000 dolarów jest znaczna. Nie dowodzi to jednak, że badacz ma dwie równie dostępne oferty. Przy ustalaniu zasad uwzględnij budżet programu, warunki kwalifikacji zgłoszenia i czas obsługi.
Program nie musi dorównywać każdej stawce brokera. Powinien jasno opisywać nagrody, terminy i warunki ujawniania, żeby badacz mógł świadomie wybrać współpracę.
Trzy obszary do sprawdzenia w VDP
Zacznij od SLA, nagród i obsady triażu. Poniżej wykorzystujemy konfigurację modułu CSIRT w Kit jako przykład. Te same pytania warto zadać przy programie prowadzonym na innej platformie lub przez security.txt i wspólną skrzynkę.
Oddziel termin potwierdzenia od terminu rozwiązania
Potwierdzenie przyjęcia zgłoszenia i rozwiązanie problemu to różne czynności. Pierwsza informuje badacza, że zgłoszenie dotarło do zespołu; druga wymaga oceny i odpowiedniego działania. Podaj osobne terminy.
W Csirt::SlaConfig Kit domyślny cel potwierdzenia wynosi 72 godziny. Cele rozwiązania zależą od ważności: 24 godziny dla super-critical, 72 godziny dla critical, 7 dni dla high i dłuższe terminy dla medium oraz low. Dopasuj je do możliwości zespołu i sprawdź, czy obsada wystarczy przy większej liczbie zgłoszeń.
Ustal najwyższy próg nagród i zasady obsługi duplikatów
Kit rozróżnia super_critical (CVSS 10.0) i critical (9.0 do 9.9). BountyMatrixConfig zawiera wzorcowe progi od 0 dolarów za zgłoszenia informacyjne do 5 000–10 000 dolarów za super-critical. Własne progi ustal zgodnie z zakresem i budżetem programu.
Przedział 5 000–10 000 dolarów jest 50–100 razy niższy od maksymalnej ceny 500 000 dolarów w cenniku brokera. To porównanie stawek, nie potwierdzonych ofert za błąd opisany przez Kuesa. Sposób ustalania progów omawiamy w artykule jak ułożyć poziomy nagród w bug bounty.
Opublikuj także reguły rozstrzygania duplikatów, np. warunki uznania pierwszego prawidłowego zgłoszenia. Przy większej liczbie badań tego samego produktu kilka osób może znaleźć ten sam błąd. Więcej w artykule o rozstrzyganiu sporów o wypłaty w bug bounty. Kit ma domyślnie włączone wykrywanie podobnych zgłoszeń w TriageConfig; wskazanie podobieństwa nie rozstrzyga sporu o nagrodę.
Sprawdzaj wiarygodność i pilność zgłoszeń
Triaż ma teraz dwa zadania, które ciągną w przeciwne strony. Musi odrzucać przekonujące fałszywki oraz szybko walidować prawidłowe zgłoszenia o wysokiej ważności, często w tej samej kolejce tego samego dnia. Przy dużej liczbie zgłoszeń zespół może nie mieć czasu na oba zadania naraz.
Odsiewanie to pierwsza połowa. Csirt::AiScreening w Kit zapisuje ocenę modelu ai_confidence_score (od 0,0 do 1,0) dotyczącą podejrzenia śmieci AI i oznacza znane sygnały fabrykacji: zahalucynowane funkcje, zmyślone CVE, wcześniejsze CVE podane jako nowe czy zgłoszenia bez konkretnego proof of concept. Ta warstwa powstała z myślą o problemie śmieci i wciąż musi działać, bo śmieci nie znikną.
Oprócz sprawdzania wiarygodności potrzebujesz reguł eskalacji. TriageConfig w Kit obsługuje poziomy wymagające eskalacji (domyślnie critical i super_critical), wymóg ponownego testu oraz opcjonalne przypisanie do osoby na dyżurze. Dostępne są rotacje dyżurów i integracja z PagerDuty. Skonfiguruj je i sprawdź, kto odbierze pilne zgłoszenie.
Co zrobić w tym kwartale
Przejrzyj poniższe ustawienia i przetestuj obsługę zgłoszeń:
- Rozdziel SLA. Opublikuj szybki, stały cel potwierdzenia oraz cele rozwiązania stopniowane według ważności. Zarezerwuj najbardziej napięty cel rozwiązania dla najwyższego poziomu powyżej „critical”.
- Przejrzyj najwyższy próg nagród. Sprawdź, czy kwoty odpowiadają budżetowi, zakresowi programu i wadze zgłoszenia. Wyjaśnij warunki wypłaty.
- Opublikuj regułę deduplikacji, zanim będzie potrzebna. Wygrywa pierwsze ważne, w pełni odtwarzalne zgłoszenie. Napisz to na piśmie teraz, a nie w trakcie sporu.
- Oceniaj wiarygodność i pilność osobno. Analiza AI może wskazać podejrzane elementy tekstu. Zespół weryfikuje zgłoszenie, a reguły eskalacji kierują pilne sprawy do odpowiednich osób.
- Mierz czas potwierdzenia. Sprawdzaj go według poziomów ważności i reaguj na narastające zaległości.
Relacja o badaniu za 25 dolarów nie wyznacza uniwersalnego kosztu znalezienia błędu. Daje jednak powód, by przetestować, jak program poradzi sobie z większą liczbą prawidłowych zgłoszeń krytycznych.
Konfiguracja programu w Kit
W module CSIRT i VDP Kit skonfigurujesz poziomy ważności, osobne cele potwierdzenia i rozwiązania, progi nagród oraz eskalacje. Wykrywanie podobieństw pomaga znaleźć powiązane zgłoszenia, a screening AI wskazuje elementy wymagające sprawdzenia.
Jasne zasady wypłat, szybkie potwierdzanie zgłoszeń i przewidywalny triaż zmniejszają utrudnienia po stronie badacza. Sprawdź te elementy, zanim wzrośnie liczba zgłoszeń.
Powiązane artykuły
Funkcje tworzone przez AI: jak zachować spójność produktu
Oceń funkcje tworzone przez AI: problem klienta, zakres, cały proces i odpowiedzialność za wynik. Sprawdź, czy warto zwiększać złożoność produktu startupu.
Wdrożenie juniora pracującego z AI: plan nauki w praktyce
Zaplanuj naukę juniora korzystającego z AI: zadania pod opieką, czas mentora i sprawdzanie wiedzy przed zwiększeniem odpowiedzialności za system produkcyjny.
Co obejmują benchmarki AI? Zaplanuj zatrudnienie w startupie
Zanim zmienisz plan zatrudnienia, sprawdź zakres benchmarków AI. Opisz zadania, przetestuj brakujące przypadki i ustal, co nadal wymaga pracy ludzi.
Prompt injection w nagłówkach HTTP: audyt agenta rekrutacji
Sprawdź prompt injection w nagłówkach HTTP: wyniki pobierania, przekierowania i błędy. Zachowaj źródła i kontroluj uprawnienia agenta rekrutacji.
Odzyskiwanie kluczy dostępu: test przed włączeniem wymogu
Przetestuj odzyskiwanie kluczy dostępu, zanim staną się obowiązkowe: utratę urządzeń, brak zapasu, zgodę administratora i nadal aktywne sesje.
Odwołane targi pracy? Dotrzymaj umówionych rozmów
Po odwołaniu wydarzenia rekrutacyjnego zadbaj o umówione rozmowy: wyznacz osobę odpowiedzialną, skontaktuj się z kandydatami i daj im wybór, co dalej.
Wypróbuj Kit przez 30 dni.
Rekrutacja, zgłoszenia podatności i szkolenia w jednym koncie, dla zespołów, w których nikt nie robi tego na pełny etat. Kartę podajesz na starcie; zrezygnuj przed końcem okresu próbnego, a nic nie zapłacisz.
Zacznij za darmo